Digital resources in the Social Sciences and Humanities OpenEdition Our platforms OpenEdition Books OpenEdition Journals Hypotheses Calenda Libraries OpenEdition Freemium Follow us

RSS revisited

@MartaLatour hat – wahrscheinlich aufgrund der fortschreitenden Degenerierung der News-Suche – einen RSS-Reader installiert und sich via RSS einen eigenen Newsraum angelegt und ist begeistert davon.

Wer sich die Mühe nicht machen möchte, aber dennoch von RSS profitieren will, kann nach wie vor das Angebot Nachrichtentisch von Peter Tomuscheit verwenden, unlängst runderneuert und eine wahre Freude im Gebrauch. Wie heißt es im Impressum so schön?

  • privat betrieben
  • nicht kommerziell
  • keine Werbung, kein Tracking
  • keine Cookies

Mehr als man heute von jeder Webpage erwarten kann.

Karlsruher Virtueller Katalog wird 30 Jahre alt #kvk

Seit 1996 ermöglicht der KVK die parallele Suche in Bibliotheks- und Verbundkatalogen weltweit. Er verbindet internationale Bestände und macht sie über eine einheitliche Suchoberfläche zugänglich.

[@KIT_Bibliothek]

Und es ist nett, dass auf der Jubiläumsseite neben vielen Reaktionen auch die drei Initiatoren gezeigt werden: Uwe Dierolf, Michael Mönnich und Roland Sand.

Es ist sehr schön, dass eine führende Technische Bibliothek über eine solche Zeit hinweg ein so brauchbares Instrument für die wissenschaftliche Recherche anbietet und auch weiter entwickelt! Herzlichen Dank für den KVK!

Doch ein bisschen Essig sollten wir bei all’ dem berechtigten Lob schon in den Wein gießen:

Schon beim 20jährigen Jubiläum hat netbib moniert, dass die Library of Congress aus dem Verzeichnis gefallen ist und seitdem nicht mehr aufgenommen wurde! – Man hätte ja dasselbe Vorgehen wählen können wie bei der British Library, die zwar aufgeführt wird, aber dann jeweils meldet: “requests_from_KVK_are_blocked_by_British_Library”. Dann kann man immerhin den KVK als Linksammlung verwenden und die British Library direkt ansteuern.

Vielleicht sollten wir in diesem Zusammenhang noch auf den kleinen Konkurrenten vom KVK hinweisen, das ZACK Gateway. Es hat als “Suchmaschine für Bibliotheksdatenbanken, die über das Z39.50 Protokoll ansprechbar sind” eine andere Zielgruppe als der KVK im Blick, aber ich denke, dass viele Kolleg*innen, vor allem aus Spezialbibliotheken, sich noch gerne an dieses Rechercheportal erinnern, das ihnen Daten zur Übernahme mundgerecht lieferte.

–

Aus dem Nähkästchen geplaudert: Änderung der Google-Suche

Keine Banner, keine Ads – die Werbung wandert direkt in die Antwort. Was verdeckt ist, ist die blitzschnell vorhergehende Auktion, wer bzw. wessen Werbung zum Zug kommt, die dann direkt in die Antwort eingeflochten wird. Und dafür benötigt Google die ganzen Daten aus den verschiedensten Diensten, um das Menü gebrauchsfertig anrühren zu können, ein Menü, das fast ohne Hinweis auf die Quellen auskommt.

Ein sehr instruktiver Bericht aus dem Weblog von Matthias Ott, zwar englischsprachig, aber sehr gut zu verstehen! Vielleicht sollte man sich das Ende seines Beitrags nochmal auf der Zunge zergehen lassen:

Google is betting its entire future on a world where people eagerly hand over their emails, their files, their habits, and their trust – to an AI system that will quietly auction off their attention, word by word, to the highest bidder. The ad infrastructure is ready. The question is whether the audience is.

[via rivva]

“Suchmaschinen gaben uns Quellen, KI-Systeme geben uns Antworten”

“Das Ende der Suche” lautet der Titel des Beitrags von Maren Burghard im Blog des Deutschen Museums betitelt, der – wie ich finde – den Paradigmenwechsel bei der Recherche gut auf den Punkt bringt:

Hier zeigt sich die eigentliche Verschiebung der medialen Ordnung. KI-Systeme organisieren Wissen nicht mehr als offenes Netz von Verweisen, sondern als schlüsselfertig erzählte Einheit. Sie bestimmen, was relevant ist und wie es erscheint. Für alle, die Informationen öffentlich zugänglich machen – ob Institutionen, Redaktionen, Organisationen oder einzelne Personen –, verändert sich damit die Situation grundlegend. Digitale Sichtbarkeit hängt nicht mehr allein davon ab, ob Informationen irgendwo im Netz bereitstehen, sondern ob sie in den Antworten der Systeme überhaupt noch vorkommen – und in welcher Form sie dort erzählt werden.

Das macht es auch so schwer, es in die Informationskompetenz-Curricula zu integrieren, da es sich nicht – wie bisher – darum handelt, etliche neue Quellen mit knappen Anweisungen ins Skript/in den Ablauf zu integrieren, sondern um die Frage, wie und wo das methodisch seinen Platz hat und wieviel von den “alten” Inhalten man weiterhin vermittelt.

Langsame, systematische Austrocknung der Internetquellen

Erste große Website wegen Googles AI Suchergebnissen geschlossen
Übersicht mit KI: Erste große Website macht ganz konkret wegen Googles AI Suchergebnissen dicht – weil sie deshalb keine Besucher mehr “erfährt”.

Der Diebstahl der KI und die Effekte, die dies für die Internetnutzug und -recherche haben wird, wird hier plastisch geschildert. Holland-Cycling.com schließt 2026 seine Homepage. Artikel auf Herrmontag.

Überblick über Bibliotheksdienstleistungen auf e-teaching.org

Neu im Portal: Bibliothekswissenschaftlerin Anja Dorn beschreibt auf e-teaching.org, wie digitale Bibliotheksdienste neue Perspektiven für #Lehre, Forschung und gesellschaftliche Teilhabe eröffnen. 👉 https://www.e-teaching.org/projekt/organisation/digitale-bibliotheksdienste

— e-teaching.org (@e-teaching.org) September 10, 2025 at 10:00 AM

Dank an die Software, die hinter dem Angebot nicht sichtbar ist.

@base schreibt auf Mastodon über #libxml2, auf dessen Dienstleistung das Angebot fußt, indem die geharvesten Daten damit in eine Ordnung gebracht werden. Ein Hinweis auf die vielfältigen Beziehungen von Open Source Software. Beziehungen heißt auch Abhängigkeit, das kommt in dem Beitrag zum Ausdruck. Deshalb Danke! Wir alle schätzen das Angebot von BASE sehr!

Mit Faktencheck käme man nicht weiter

“Im Artikel stehen Passagen, die man der Nachrichtenlogik folgend eben einfach zitiert, denn man ist ja nur Nachrichtenredaktion, nicht Faktencheckabteilung. Und mit einem Faktencheck käme man an vielen Stellen auch gar nicht weiter, denn wenn jemand die Wirklichkeit bis ins Unkenntliche verdreht, müsste man oft schon ziemlich weit ausholen, um das zu erklären.”

Meiner Meinung nach einer der wichtigsten Newsletter zurzeit, weil er jeden Tag den Finger in die Wunde (des Journalismus, der öffentlichen Wahrnehmung) legt: Das Altpapier.

Änderungen im Suchmaschinenbereich

Sven Gigold referiert den Trend, dass Suchmaschinen eher zu Findemaschinen werden und dass der AI-Einbingungstrend dies noch verstärkt, so dass tendenziell weniger Traffic von Suchmaschinen zu Homepages, insbesondere zu mittleren und kleinen geleitet werden. Die diskutierten Lösungen – Blogrolls, Aggregatoren oder Linksammlungen überzeugen nicht recht, weil sie die Masse der Homepages gar nicht erschließen können und auch schnell(er) veralten. Zumal ja zu Recht gesagt wird, dass viele schon von den Suchmaschinen abgewandert sind und die Suche bei TikTok, YouTube oder Reddit verwenden …

Übrigens, Sven Gigold hat UberBlogr aufgebaut.

Neues KI-Suchinstrument

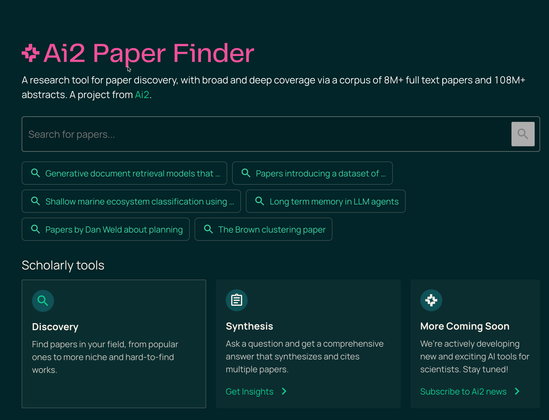
Cool! NEW Research Tools: Allen Institute for Artificial Intelligence Introduces Ai2 Paper Finder infodocket.com/2025/03/27/rese #AI #researchtools #libraries

null

Die Ergebnisse stammen – wie bei Elicit – aus der Datenbank Semantic Scholar. Man könnte die beiden Suchinstrumente also miteinander vergleichen.